Reading Neural Capture of Animatable 3D Human from Monocular Video
论文地址:
作者:Gusi Te, Xiu Li, Xiao Li, Jinglu Wang, Wei Hu, and Yan Lu
发表: ECCV 2022
链接: https://arxiv.org/abs/2208.08728
Why:
- 之前的3D人体重建工作一般需要多视角视频,或者额外的3D几何信息。这篇工作以单视角视频为输入
- 之前的工作建模出来的3D人体很难泛化到新的pose
- 之前的工作都只能解决一部分的问题:基于参数化人体模型的方法对appearance的表示精度有限;基于NeRF的方法的appearance效果好,但是要么只关注于NeRF场本身的构建,要么需要精确的3D mesh作为先验。
What:
- 提出一个从单视角视频重建animatable的3D人体的方法
- 表示方法是把 dynamic NeRF 和一个 human mesh (SMPL)相结合。这个 dynamic NeRF 的输入是一些嵌入到mesh 顶点的局部信息,这样,当需要表现一个人不同的姿势的时候,本质上是对这个 canonical space 的静态NeRF进行deformation。这里的关键问题是如何设计这个局部信息,来让查询observation space中的任意一点的时候,都能够良好地deform到canonical space,从而找到静态NeRF里正确的点
- 在优化过程中,首先借用别的工具初始化一个mesh pose,然后逐帧地同时 finetune mesh pose 和 NeRF
How:
Query embedding for NeRF
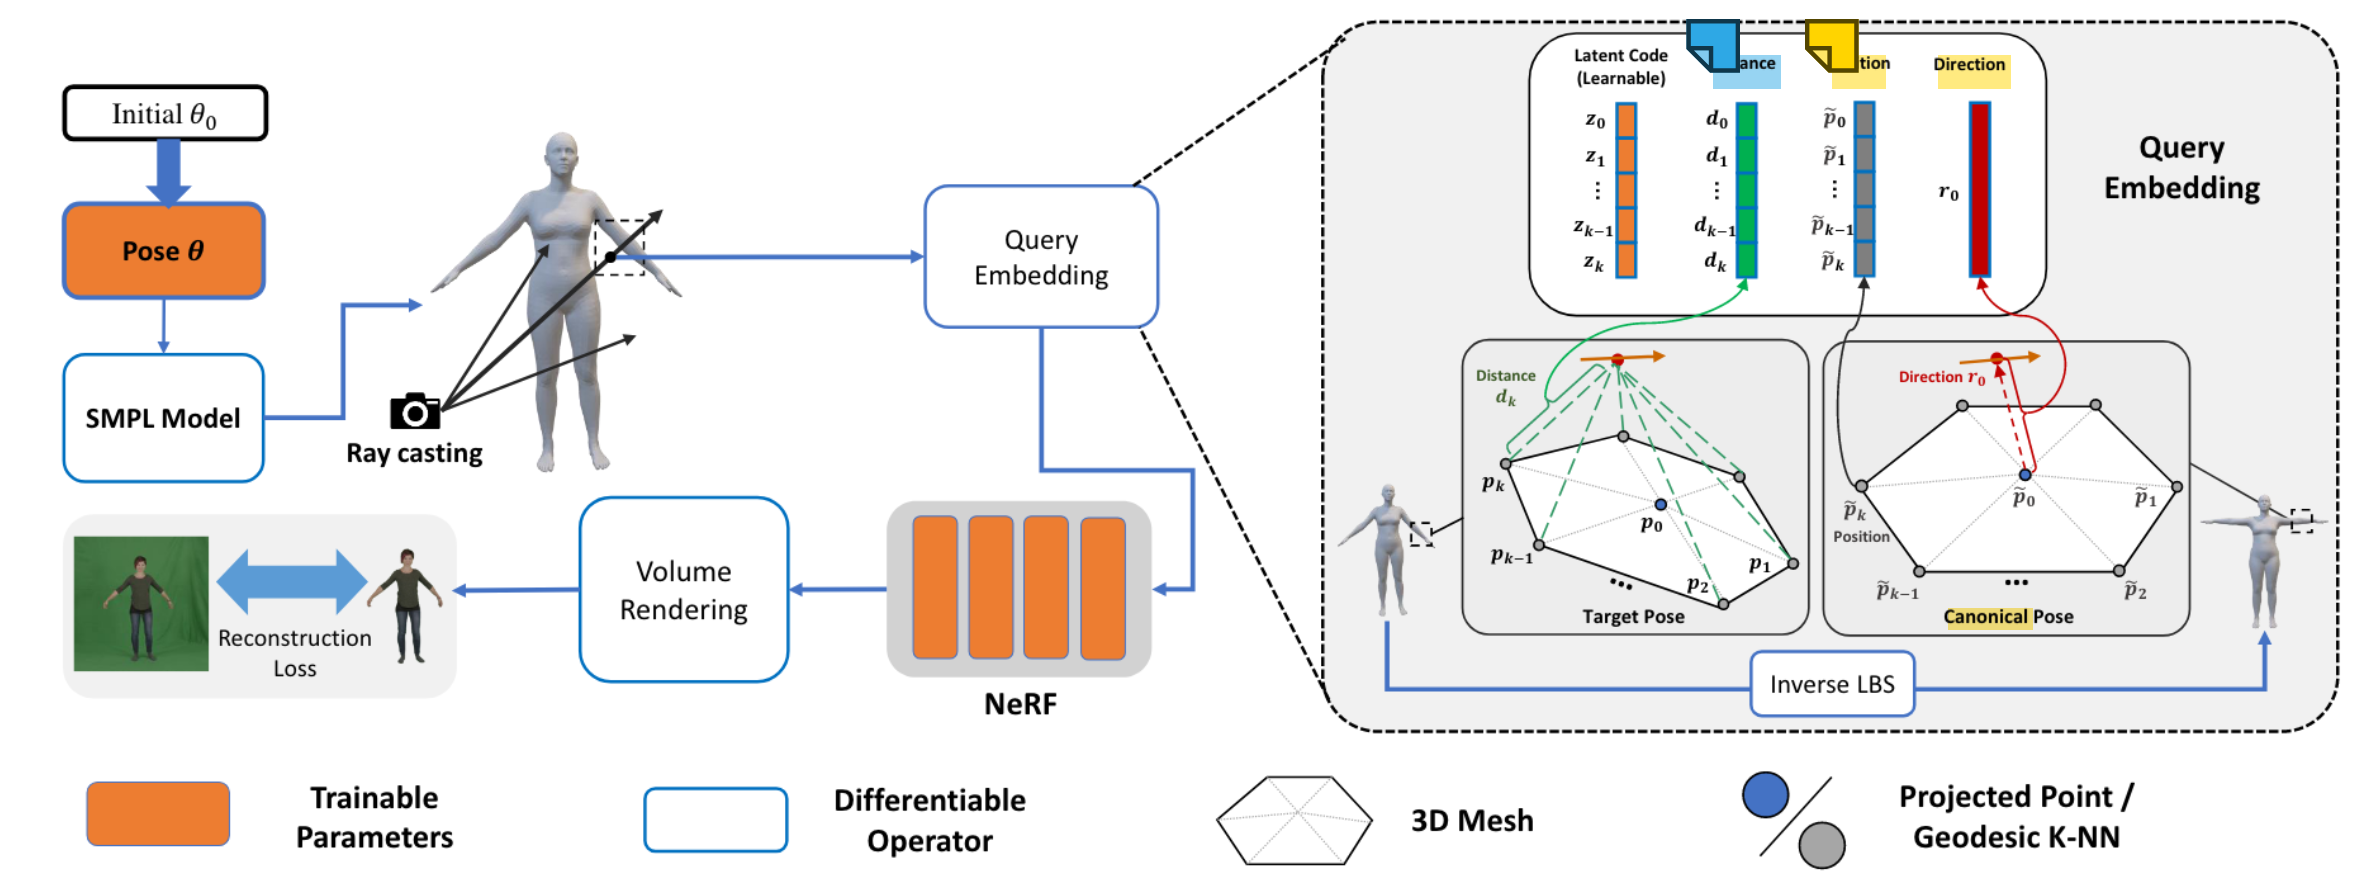
精髓就在图里了:
人体的表现形式是我们熟悉的:首先有一个由pose参数\(\theta\)驱动的SMPL mesh,以及一个mesh-guided NeRF,后者的输入是对应query ray上的3D points的embedding
Query embedding的具体构成:
- 最直观的 Latent Code:存储在每一个mesh顶点上,表示的是appearance信息。对于一个query point,会找到mesh顶点中K nearest neighbors所对应的latent codes
- 被称为 Deformation Guidance:其实是在canonical space中,刚刚用到的那些KNN顶点的坐标(用inverse LBS得到),以及query point相对于mesh表面投影点的方向。这个信息能够指导deformation field,所以叫guidance
- 另一方面还有 Deformation Priors:是在observation space中,query point相对于刚刚用到的那些KNN顶点的距离。文中说这是用来防止deformation field落入local minima的,所以叫做priors
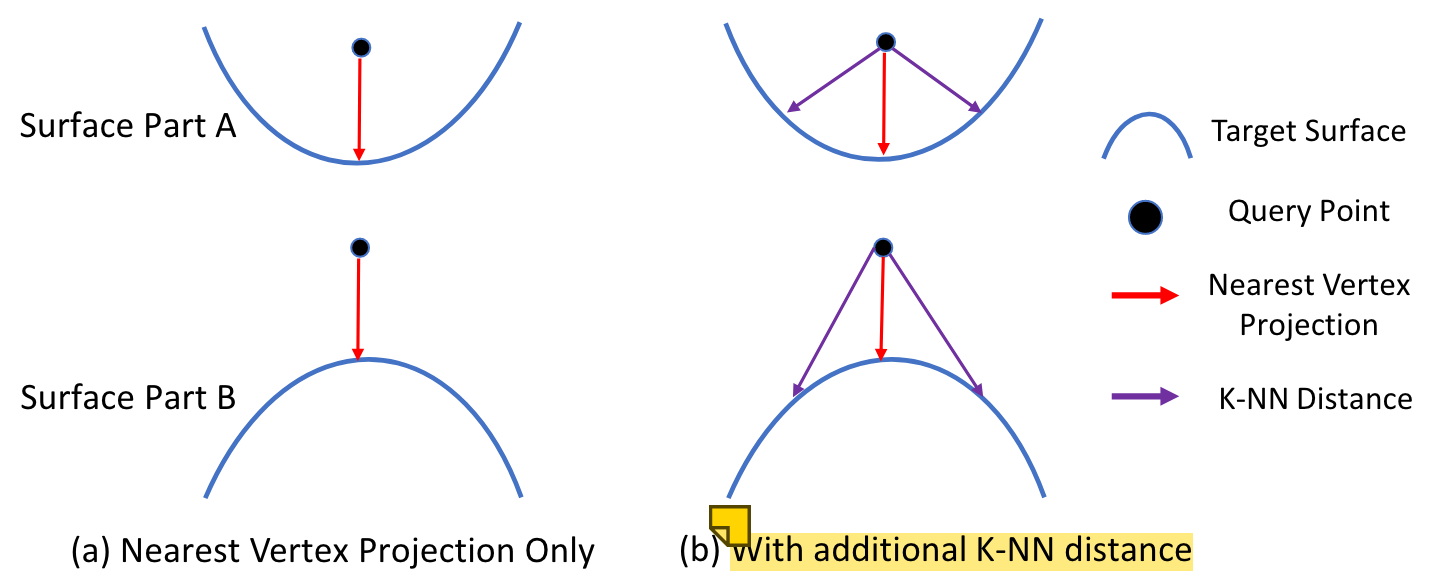
image-20231124052407094 文中特意用上图强调了这里需要用到K近邻顶点,而不是单个最近的顶点。因为如果只用单个最近的顶点(图a),就不能提供不同的deformation pattern 的信息;而(b)里加上了K-NN distance之后,就能有这个deformation pattern信息了。(我有点疑惑什么是deformation pattern,就是这个表面的凹凸性吗?)
训练过程
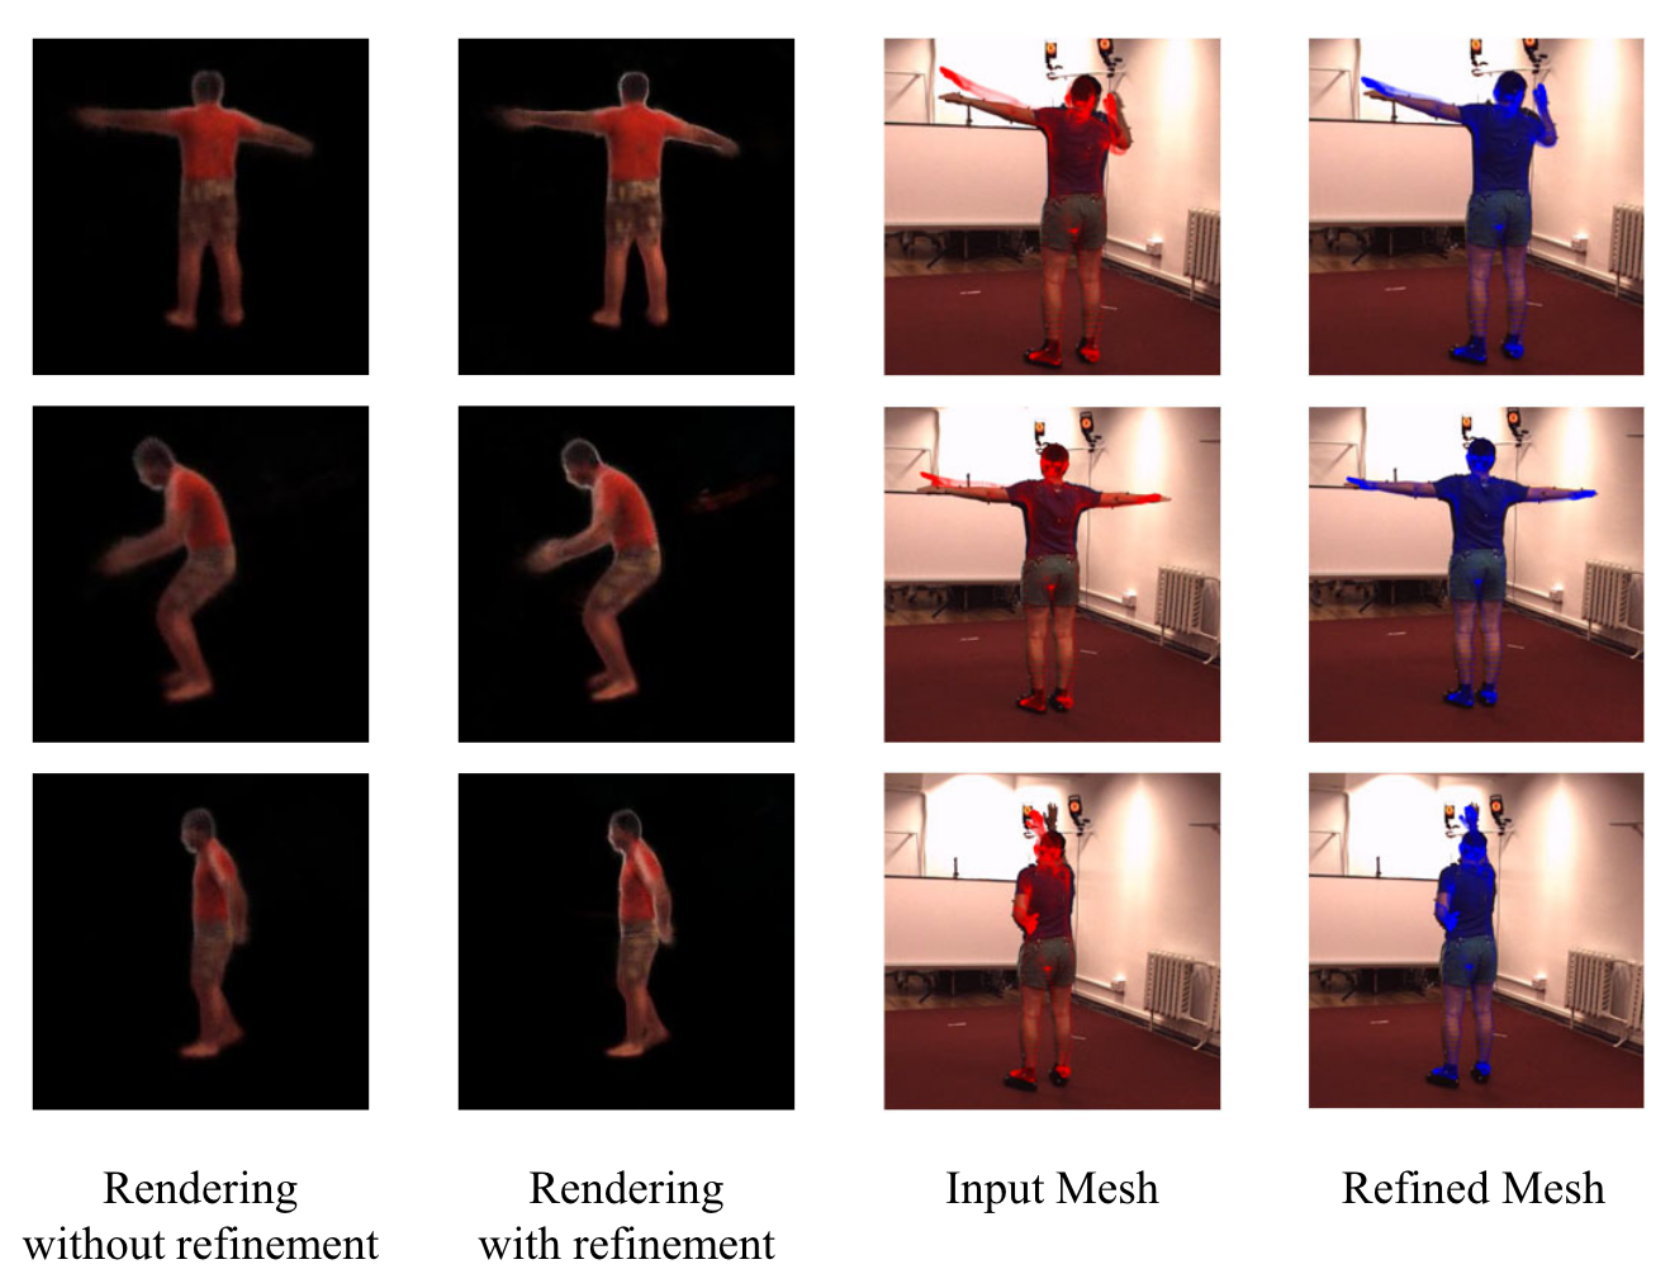
- 首先借用别的工具初始化一个mesh pose。但是这个pose不够精准,还需要finetune。文中提到这里直接是finetune per-frame pose parameter,而不用per-vertex offset,因为后者可能容易过拟合到local minima(?有点疑惑,我以为用pose parameter或许是有利于在后续用temporal consistency之类的,但是好像并没有用到;那pose param相比之下就是一个更不精准而已?)
- 训练时逐帧地同时 finetune mesh pose 和 NeRF。loss很直观:
- NeRF渲染图和原视频帧的L2 loss
- 正则 \(\|\theta-\theta^0\|^2_2\),是为了让每帧的pose finetune不至于太偏离初始估计
实验
- 训练要在v100上60小时;数据集用到People-Snapshot、DoubleFusion、ZJU-MoCap、Human3.6M;指标用PSNR和SSIM
- 在2022,没有什么能直接对比的其他工作,跟需要多视角视频输入的AniNeRF、底层架构很不同的A-NeRF、mesh-based 的方法VideoAvatar比了三下,比他们都好