Reading 3D Photography using Context-aware Layered Depth Inpainting
论文地址:https://shihmengli.github.io/3D-Photo-Inpainting
作者:Meng-Li Shih, Shih-Yang Su, Johannes Kopf, Jia-Bin Huang
发表: CVPR2020
链接: https://github.com/vt-vl-lab/3d-photo-inpainting
Why:
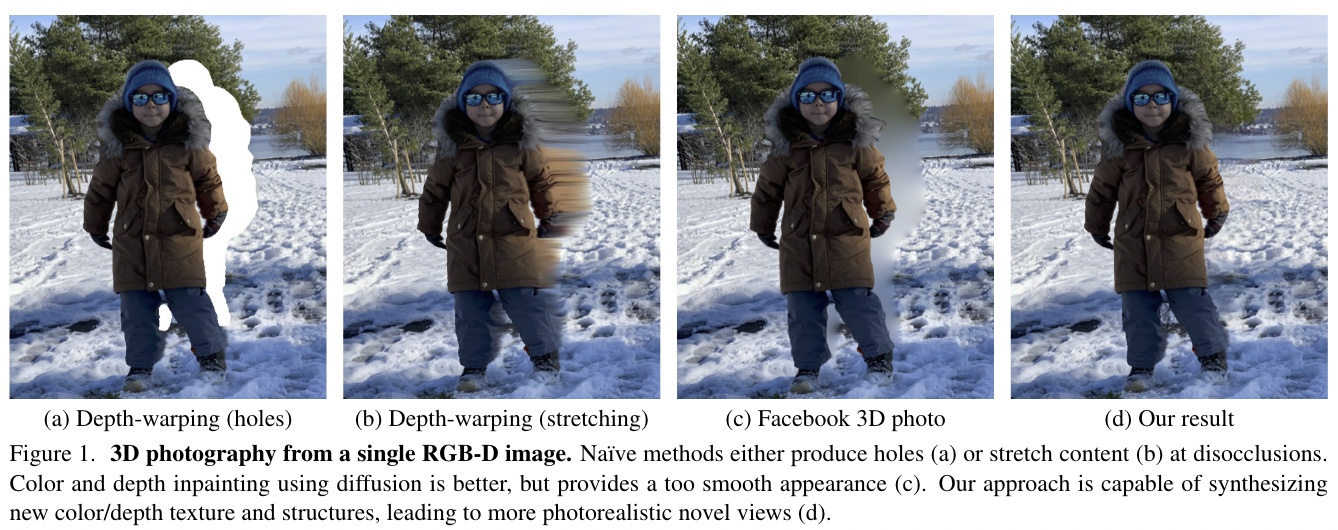
之前的照片3D化的方法,会在视角变动后出现的新像素区域 填充很模糊的背景;这个方法主要是用inpainting的方法提高新背景生成的效果
What:
- 任务是3D photography,图像3D化,把一张2D+深度信息的RGB-D图像转化成3D风格的图像。
- 现在的多镜头智能手机拍的照片都能提供深度信息。没有的话,也能用其他模型预测深度。
- 用分层深度图像(Layered Depth Image)来表示图像:能显式地表示像素点之间的连通性。和普通的2D图像相比,可以把像素点分成多层来表示,同一个坐标处可以有重合的不同层次的像素点。
- 提出一个基于学习的 inpainting 方法填充重叠区域的像素,让3D图像视角变化的时候出现的新背景效果很好。
How:
是一个很清晰的流程:
输入为单张RGB-D图像。D为depth,一般多镜头智能手机拍摄的照片都能提供深度信息;没有的话就用其他模型预测深度,比如MegaDepth, MiDas, and Kinect depth sensor
将输入图像转化成分层深度图像(Layered Depth Image)。LDI中的每个像素点保存颜色和深度信息,以及上下左右四个方向的邻居像素点。同一个坐标处可以有重合的不同深度的像素点。
图像预处理:检测深度不连贯的边缘
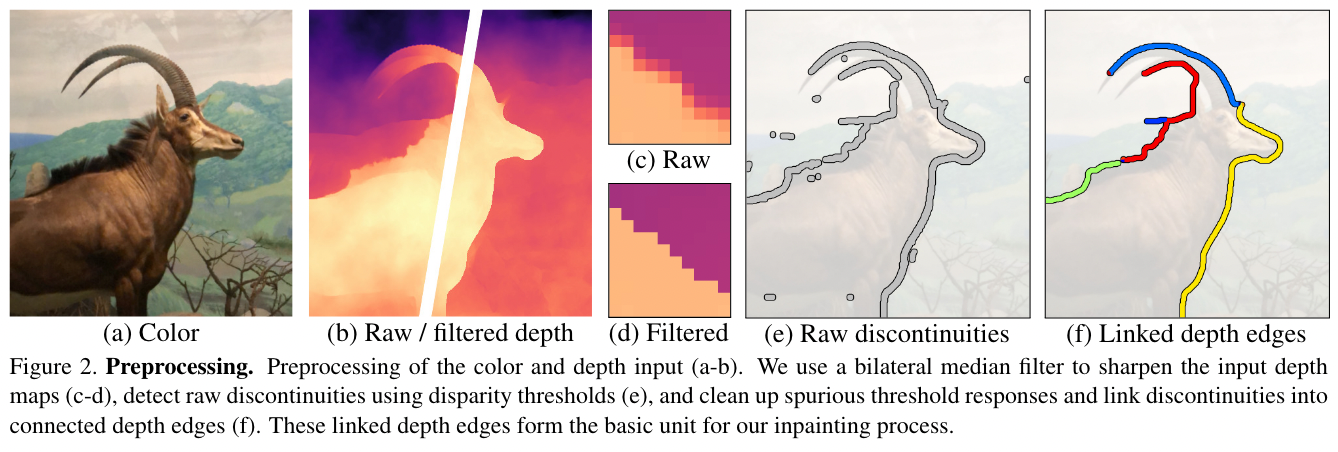
image-20221007090910332 用filter把深度边缘过滤得更锐利,然后清理一些不连贯的边缘,最后根据连通性划分不同的深度边(如图2 (f)中,不同颜色表示不同深度边)。
对于每一个深度边,把LDI图中的像素点切割开,并在背景层扩展一些像素点,对扩展区域进行生成
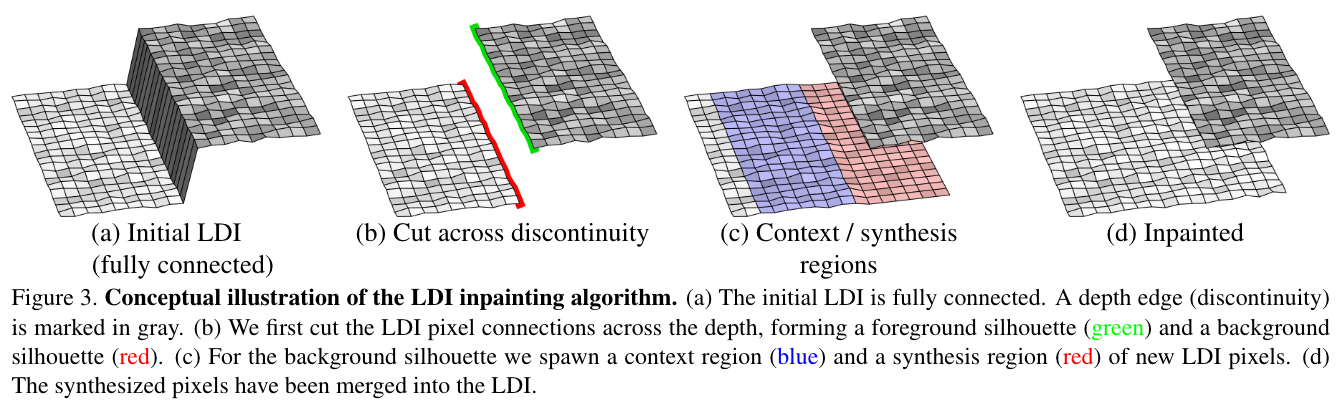
image-20221007091217942 找到一个深度边,把两层的像素点切割开
对于背景层,用flood-fill like算法迭代地选取一定的已知区域作为context region,以及扩展一定的未知区域作为synthesis region
利用已知context region 生成未知synthesis region 的深度和颜色:采用基于学习的inpainting方法
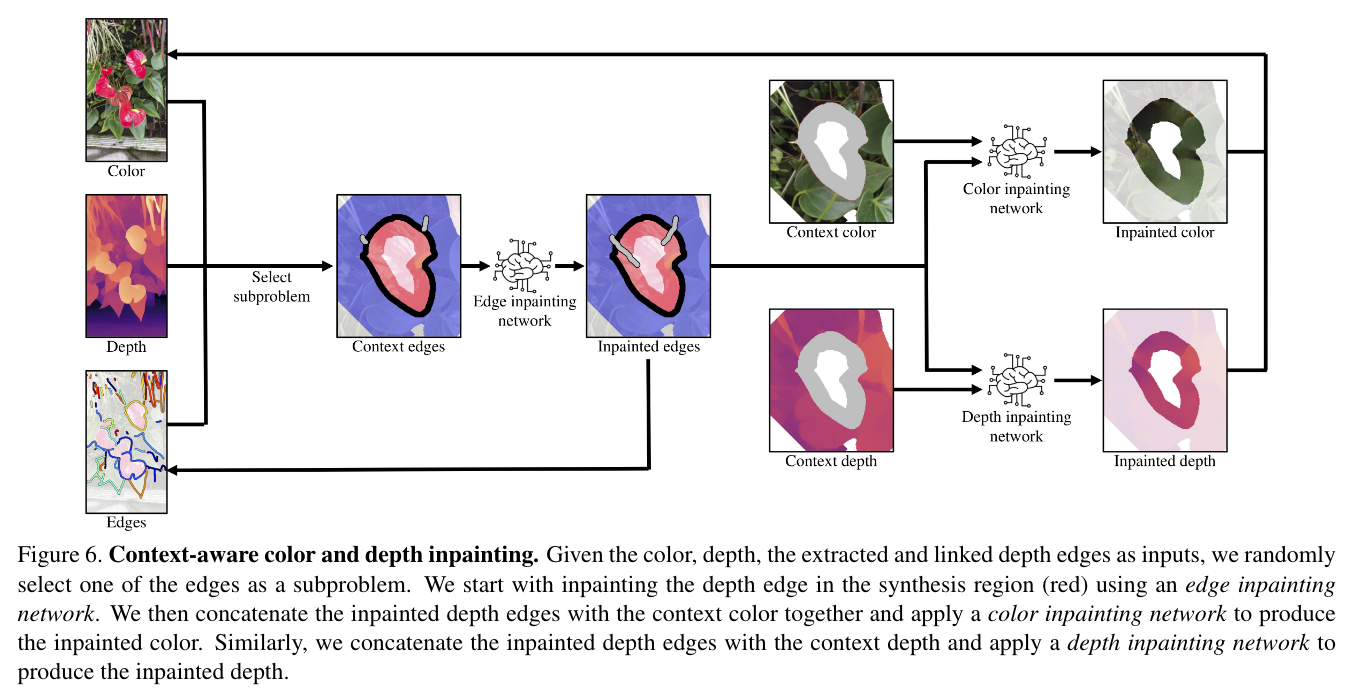
image-20221007091716266 这个方法中,最关键的就是在预测color和depth之前,先预测了一下depth edges,然后把这个edges信息加进去,可以更好地预测color和depth。
将生成完毕的像素融合回LDI图像